Cuál me necesita
Antes dejaba una ventana de terminal abierta por agente. Hasta unos 3 podía seguirlos (es un número a ojo), pero con 10 pasaba demasiado tiempo cambiando de ventana con alt-tab. El quiebre fue encontrar a un agente que llevaba 9 minutos esperando un permiso sin que nadie lo viera.
Quería ver cuál agente me necesitaba sin abrir todas las ventanas. Este setup no mejora el código que escriben. Me ayuda a manejarlos, sean 4 agentes o 20.
Uso Ghostty con herdr, 23 atajos y unas 220 líneas de shell.
Cómo les paso el trabajo
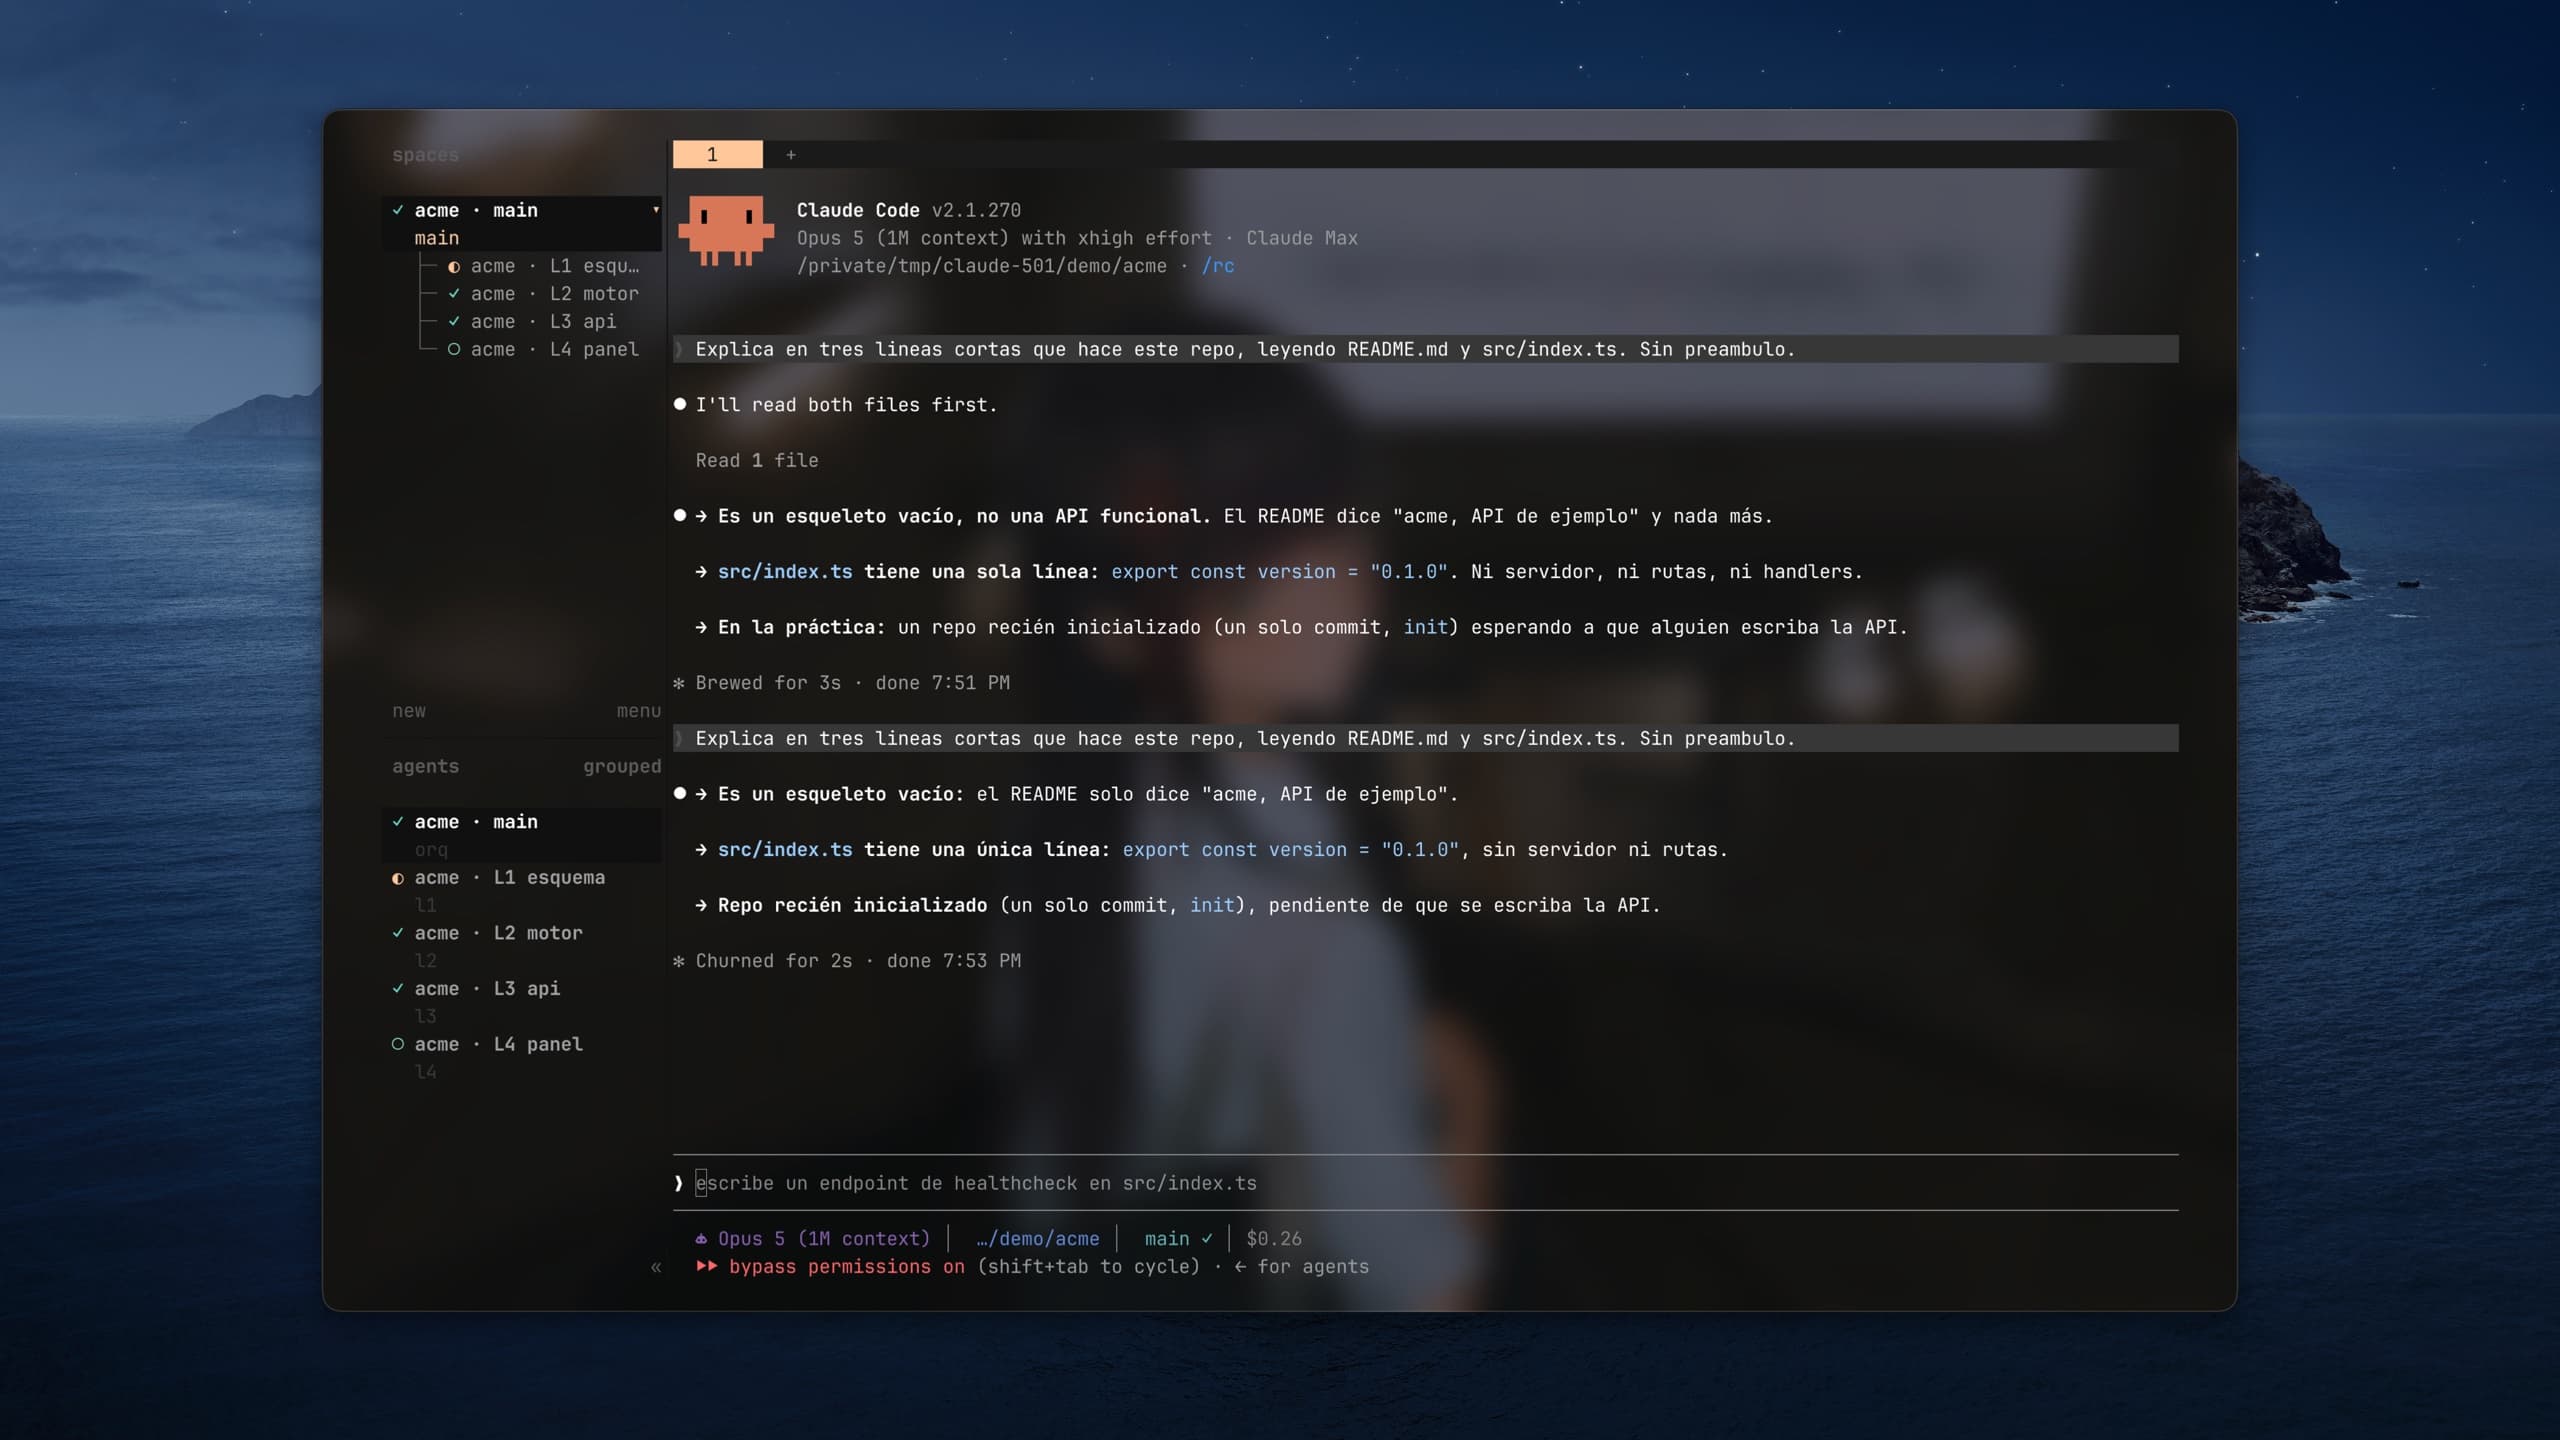
La config de la terminal, las teclas y los worktrees están en El setup por debajo. Acá quiero explicar cómo les paso trabajo a los agentes y cómo recibo el resultado, que es el ejemplo que me habría servido tener cuando partí.
Hay tres niveles. Cada uno revisa el trabajo y escribe un resumen para que el de arriba no tenga que leerlo todo. Los tres orquestadores usan Claude Code. No editan código: investigan, revisan y me cuentan. Los agentes de los carriles escriben el código, cada uno en su worktree.
Yo solo hablo con el orquestador principal. Si un carril necesita una decisión, le pregunta a su suborquestador, que se la pasa al principal. Antes de preguntarme, el principal revisa también el resto del trabajo que está corriendo, lo que me permite tener 16 paneles abiertos y seguir una sola conversación en una ventana.
Si le respondo directo a un carril, tengo otra conversación que seguir y el contexto se desarma, así que no lo hago.
¿Para qué dejar el nivel del medio? Necesito que investigue y revise mientras los carriles escriben. El mío responde seguido que no tocó nada, lo que es la respuesta correcta si todavía le falta evidencia. Al final lee las cuatro ramas, revisa qué carriles dijeron que estaban listos sin estarlo, y ordena los commits para el merge.
El carril le devuelve el resultado al orquestador que le pasó el briefing, porque una rama lista no significa que terminó.
Uso tres tipos de agente, según lo que costaría un error. Claude Code toma las decisiones en cada nivel de orquestador, mientras que los carriles usan Devin con SWE-2 y Gemini Flash 3.8 a través de agy. Son rápidos y baratos, y a esa altura el trabajo ya está lo bastante claro para revisar si lo terminaron.
El briefing
Cuando ya revisó el problema, el orquestador escribe un briefing con seis partes.
Tomemos la falla de voz en staging: después de revisarla, el orquestador le manda esto al carril:
1 objetivo    la voz está rota en staging. la causa está en el
              otro servicio, no en el nuestro. confírmalo y di
              qué tienen que cambiar ellos.
2 síntoma     el endpoint que llamamos responde 403 hoy. de
              nuestro lado no cambió nada.
3 cadena      nuestro servicio -> su endpoint -> 403. los dos
              primeros eslabones verificados de nuestro lado,
              el tercero en sus logs.
4 historial   el mismo endpoint respondió 201 tres días
              seguidos. regresión, no algo que nunca funcionó.
5 descartado  nuestro request y nuestra config. aquí van rutas
              y líneas, para que nadie las vuelva a abrir.
6 fronteras   no toques nuestro servicio. si el arreglo
              correcto es de configuración y no de código, dilo
              y no escribas código. responde en pocas líneas:
              qué cambiar, y de qué lado.
La parte 1 dice qué hacer y en qué servicio no está la falla. La 4 le cuenta al siguiente agente que esto antes funcionaba (el endpoint devolvía 201 antes de devolver 403), porque si lo dejas fuera, puede ponerse a buscar por qué esto nunca ha funcionado.
Es fácil saltarse la parte 5, pero después el siguiente agente pasa sus primeros 20 minutos revisando lo que el anterior ya descartó, pagando los tokens de nuevo y haciendo más difícil saber qué se revisó de verdad. Pon las rutas y los números de línea ahí.
Me demoré en dejar bien la parte 6. «Si el arreglo correcto es de configuración y no de código, dilo y no escribas código» le dice al agente que está bien volver sin un parche. Si no, pregunto por un bug y recibo un cambio de código, aunque no hiciera falta. Decirlo directo es la única forma que me ha funcionado.
En este ejemplo de staging espero unas líneas pidiendo un cambio de config en el otro servicio, sin parches de nuestro lado. Eso vuelve por el suborquestador al principal y me llega junto con las otras decisiones del día, sin tener que ir a preguntarle al carril qué pasó.
Mensajes entre agentes
Los mensajes parten con quién los manda, como orq-main: URGENT — …. orq es como le digo al orquestador. El otro agente ve quién pregunta y cuánto peso darle. Si el caso es de otro dominio, se lo pasa al orquestador que conoce esa área con el mismo briefing de seis partes, para que no tengan que explicar todo de nuevo.
Busco dos hábitos, y si falta cualquiera, cambio al orquestador.
Tiene que corregirme. Un reporte de esta semana partía con «Premisa corregida: la UF es ISO 4217». El trabajo había arrancado con el supuesto contrario y la primera línea lo decía: bien. Dímelo temprano, aunque tengamos que buscar por otro lado.
También tiene que preguntar cuando no sabe. Preguntar «¿Tengo acceso a los logs de staging, o los sacas tú?» toma segundos, mientras que una suposición puede costar una tarde, y quizás recién después me entere de que no había usado los logs.
Qué miro
Sigo a los agentes desde la barra lateral, sin mirar sus paneles. Dejo tranquilo al agente que está en working, y el que está en done puede esperar. Si está en blocked, tengo que revisar. alt+a se mueve solo entre agentes, así que llego en una o dos pulsaciones.
Mi trabajo se queda en las decisiones: defino el rumbo, sigo los cambios de estado, leo los reportes y decido qué viene después. Los orquestadores se encargan del trabajo entre medio, manteniendo el avance sin que yo tenga que meterme a cada terminal.